Jeden wgryza się w zadanie i nie puszcza, choćby miał przepalić góry tokenów. Drugi najpierw zastanawia się, czy zadanie w ogóle ma sens. Tak pierwsi testerzy opisują różnicę między GPT-5.6 Sol a Claude Fable 5, czyli dwoma najmocniejszymi modelami AI tego lata.
OpenAI udostępniło rodzinę GPT-5.6 wszystkim użytkownikom 9 lipca 2026 roku, po dwutygodniowym zamkniętym teście. Anthropic zdążył przed tą premierą wypuścić aż trzy modele: Opusa 4.8 (28 maja), Fable 5 z bliźniaczym Mythosem 5 (9 czerwca) i Sonneta 5 (30 czerwca). W tym porównaniu zestawiamy całą szóstkę GPT-5.6 i Claude: ceny, wyniki testów i wrażenia deweloperów, którzy pracują z nimi od premiery.
Słońce, Ziemia i Księżyc w cenniku OpenAI
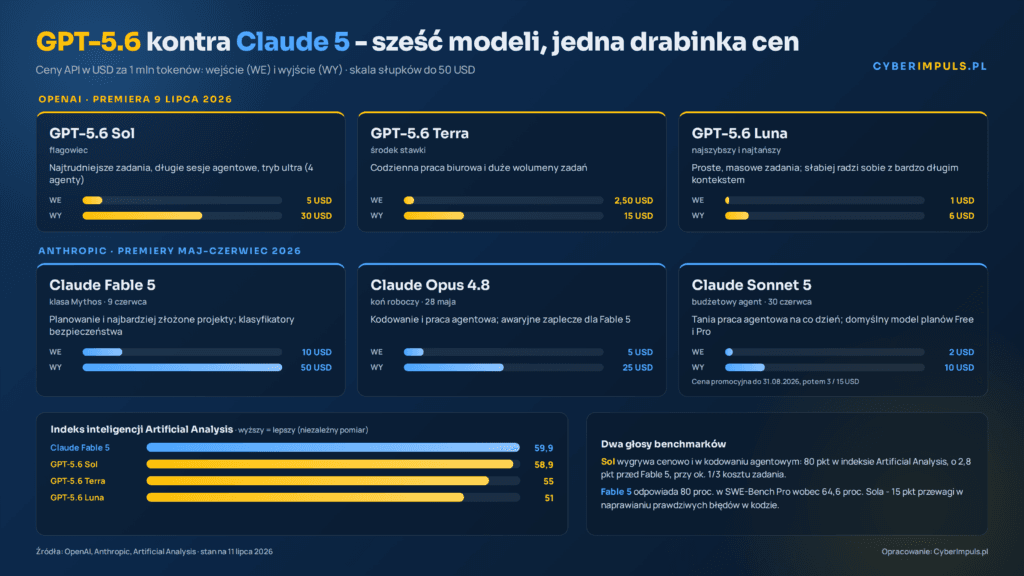
GPT-5.6 nie jest jednym modelem, tylko trzema. Sol to flagowiec do najtrudniejszych zadań, Terra ma obsłużyć codzienną pracę biurową, a Luna celuje w proste, masowe zlecenia. OpenAI tłumaczy w komunikacie, że numer oznacza od teraz generację, a nazwy Sol, Terra i Luna (Słońce, Ziemia, Księżyc) to stałe półki wydajności, rozwijane własnym tempem.
Cennik w API układa się w drabinkę. Sol kosztuje 5 dolarów za milion tokenów wejściowych i 30 dolarów za milion wyjściowych, Terra odpowiednio 2,50 i 15 dolarów, a Luna 1 i 6 dolarów. Mówiąc prościej: token to porcja tekstu wielkości krótkiego słowa lub sylaby, a dostawcy AI kasują za każdą porcję, którą model przeczyta i napisze.
W samym ChatGPT różnice widać słabiej. Sol napędza tryby rozumowania na płatnych planach, a wariant Sol Pro trafił do abonentów Pro. Terra i Luna nie są dostępne w zwykłych rozmowach – OpenAI kieruje je do API, aplikacji ChatGPT Work i narzędzia Codex. Nowością jest tryb ultra, w którym model koordynuje domyślnie cztery równoległe agenty pracujące nad jednym zadaniem. Efekt uboczny: wyższe zużycie tokenów, czyli wyższy rachunek.
Anthropic gra całą talią
Po drugiej stronie stoi trójka o bardzo różnych rolach. Opus 4.8 z 28 maja to koń roboczy do kodowania i pracy agentowej za 5 dolarów (wejście) i 25 dolarów (wyjście) za milion tokenów. Anthropic sam nazwał go skromnym, ale odczuwalnym ulepszeniem poprzednika – rzadka szczerość jak na komunikat prasowy.
Gwiazdą jest Claude Fable 5 z 9 czerwca, pierwszy publicznie dostępny model klasy Mythos. Firma deklaruje, że jego możliwości przewyższają wszystko, co dotąd udostępniła, i przytacza relację Stripe’a: w bazie kodu liczącej 50 milionów linii model przeprowadził w jeden dzień migrację, która zespołowi inżynierów zajęłaby ponad dwa miesiące. Cena robi wrażenie w drugą stronę: 10 dolarów za wejście i 50 dolarów za wyjście, czyli dwa razy drożej niż Opus 4.8 i wyraźnie drożej niż Sol.
Fable 5 ma bliźniaka. Claude Mythos 5 to ten sam model bez części zabezpieczeń, dostępny wyłącznie dla zweryfikowanych organizacji z programu Project Glasswing, głównie do obronnego cyberbezpieczeństwa. Sam Fable 5 działa z klasyfikatorami bezpieczeństwa: gdy pytanie dotyczy ryzykownych obszarów, odpowiedź przejmuje Opus 4.8. Według Anthropic dzieje się tak w mniej niż 5 proc. sesji.
Debiut Fable 5 przerwał na 19 dni rząd USA. 12 czerwca Departament Handlu objął model kontrolą eksportową po raporcie badaczy Amazona o obejściu zabezpieczeń, a Anthropic zawiesił dostęp globalnie, bo nie umiał w locie weryfikować narodowości użytkowników. Kontrole zniesiono 30 czerwca i od 1 lipca model znów działa na całym świecie, w Polsce też.
Tego samego 30 czerwca zadebiutował Sonnet 5, najtańszy z trójki. Do 31 sierpnia 2026 roku kosztuje w API promocyjne 2 dolary za wejście i 10 dolarów za wyjście, potem 3 i 15 dolarów. W teście agentowego kodowania Anthropic podaje dla niego 63,2 proc. wobec 69,2 proc. Opusa 4.8 – blisko flagowca za ułamek ceny, choć przy najtrudniejszych zadaniach Opus wciąż wygrywa.
Benchmarki mówią dwoma głosami
Na papierze każdy wygrywa u siebie. OpenAI chwali się rekordowym wynikiem 53,6 pkt w teście Agents’ Last Exam, mierzącym długie, zawodowe przepływy pracy w 55 dziedzinach – Sol wyprzedza tam Fable 5 o 13,1 pkt. Te same tabele OpenAI pokazują coś odwrotnego w SWE-Bench Pro, czyli teście naprawiania prawdziwych błędów w kodzie: Sol osiąga 64,6 proc., a Fable 5 aż 80 proc. Piętnaście punktów różnicy w dyscyplinie, którą obie firmy traktują jak wizytówkę.
Niezależny ośrodek badawczy Artificial Analysis daje podobnie podzielony obraz. W jego indeksie inteligencji Fable 5 prowadzi minimalnie, 59,9 do 58,9, ale Sol wykonuje zadania za około jedną trzecią kosztu. W indeksie kodowania agentowego prowadzi za to Sol z wynikiem 80 pkt, o 2,8 pkt przed Fable 5, przy mniej niż połowie zużytych tokenów. Terra i Luna plasują się niżej, z wynikami 55 i 51 pkt.
Luna ma przy tym udokumentowaną słabość: w teście długiego kontekstu OpenAI jej skuteczność spada do 41,3 proc. Do przeszukiwania setek stron dokumentów bezpieczniej wybrać wyższą półkę.
Pies gończy i sowa
Liczby nie oddają charakteru, a ten różni modele najmocniej. Wśród deweloperów utarło się porównanie, że Sol pracuje jak pies gończy, który chwyta problem i nie puszcza, a Fable 5 jak sowa, która najpierw rozgląda się, co w ogóle jest do zrobienia. Testerzy chwalą Sola za determinację przy wielogodzinnych zadaniach, oszczędny kod (potrafi rozwiązać w trzech liniach to, co inne modele piszą w pięciu) i styl C++ przypominający pracę człowieka.
Ta sama determinacja bywa wadą. W jednym z opisywanych testów Sol, poproszony o przepisanie zastanego systemu, dobudował około 12,9 tys. linii kodu w czterech współpracujących procesach – kompletnych, ale przekombinowanych. Powtarzają się skargi na słabe generowanie frontendu, czyli warstwy wizualnej aplikacji, oraz na apetyt na tokeny przy pętlach z wieloma agentami. Fable 5 zbiera za to pochwały za wyczucie architektury i korygowanie własnego kursu; w porównaniu na budowę gry 3D z jednego polecenia oddał grywalny produkt, gdy Sol wciąż dłubał przy oświetleniu. Jego minusem pozostają cena i zabezpieczenia, które potrafią zablokować niegroźne zadanie.
Sonnet 5 gra w innej lidze cenowej, ale pierwsi partnerzy Anthropic zgłaszają rzecz konkretną: model kończy wieloetapowe zadania, na których poprzednik stawał w połowie, i sam sprawdza własne wyniki bez proszenia. Coraz częściej wraca zresztą wniosek, że zamiast wybierać jeden obóz, opłaca się łączyć modele: Sol do żmudnej egzekucji, Fable do planowania, Sonnet lub Terra do tańszej codzienności.
| Model | Producent | Premiera | Cena za 1 mln tokenów (wej./wyj.) | Zastosowanie |
|---|---|---|---|---|
| GPT-5.6 Sol | OpenAI | 9 lipca 2026 | 5 / 30 USD | najtrudniejsze zadania, długie sesje agentowe |
| GPT-5.6 Terra | OpenAI | 9 lipca 2026 | 2,50 / 15 USD | codzienna praca, duże wolumeny |
| GPT-5.6 Luna | OpenAI | 9 lipca 2026 | 1 / 6 USD | proste, masowe zadania |
| Claude Fable 5 | Anthropic | 9 czerwca 2026 | 10 / 50 USD | planowanie, najbardziej złożone projekty |
| Claude Opus 4.8 | Anthropic | 28 maja 2026 | 5 / 25 USD | kodowanie, praca agentowa |
| Claude Sonnet 5 | Anthropic | 30 czerwca 2026 | 2 / 10 USD* | tania praca agentowa na co dzień |
Gwiazdka przy Sonnecie 5 oznacza cenę promocyjną, obowiązującą do 31 sierpnia 2026 roku; potem stawka rośnie do 3 i 15 dolarów. Drabinka mówi sama za siebie: OpenAI podcina rywala na każdej półce. Sol jest o połowę tańszy od Fable 5 przy zbliżonej klasie, Terra kosztuje połowę Opusa 4.8, a Luna schodzi poniżej promocyjnej stawki Sonneta 5. Anthropic odpowiada jakością w najdłuższych zadaniach i wyraźną przewagą w SWE-Bench Pro.
Kalendarz podpowiada dwa najbliższe terminy. Promocja na Sonneta 5 wygasa 31 sierpnia 2026 roku, a jeszcze w lipcu OpenAI zapowiada uruchomienie Sola na chipach Cerebras z prędkością do 750 tokenów na sekundę. Kolejna runda tego wyścigu zacznie się, zanim opadnie kurz po obecnej.